
AIがコードを書き、テストを書き、設計書まで更新する。そうした開発が、実験ではなく実案件で行われるようになってきた。そこで改めて問われているのが品質管理である。
本稿は、私たちがAI駆動開発を実際の開発プロジェクトへ適用してきた経験をもとに、次の問いを整理するものである。
- 従来の品質管理は何を守ろうとしてきたのか。
- AIによって何が変わり、何が変わらないのか。
- 品質管理をどう組み替えるべきか。
なお、本稿が想定するのは、複数の開発者やチーム、さらには発注者と受注者のように複数の組織が関わる中規模から大規模の開発である。一人で完結する開発や、ごく小規模なツールづくりであれば、作った本人が確かめれば済む場面も多く、ここで述べるような仕組みは過剰になりうる。品質管理の仕組みが必要になるのは、作る人、確かめる人、説明する人が分かれ、その間で品質の根拠を受け渡さなければならないときである。
先に結論を述べる。
AI時代の品質管理とは、従来のように工程ごとに品質ゲートを置く形から、生成AIと人による、より細かな作業単位ごとに品質ゲートを置く形へ移ることである。そして各ゲートでは、品質リスクに応じて強度を変え、必要な場面に人を介在させ、必ずエビデンスを残して検証できる状態にすることである。
1. 問題の所在:変更コストと失敗コストは別物である
従来の品質管理は、暗黙のうちに次の前提の上に組み立てられてきた。
- 変更はコストが高い。
- 後工程での手戻りは避けるべきである。
- だから人間が、成果物を工程ごとに段階的に確認する。
AI駆動開発は、このうち最初の前提を崩す。コード生成、再設計、テストの生成と再実行、影響調査、ドキュメントの追従。いずれも、変更そのもののコストは大きく下がった。
一方で、下がらないものがある。誤った金額での支払い、個人情報の漏洩、データの破壊、法令違反。失敗したときのコストは、AIを使ったからといって1円も安くならない。
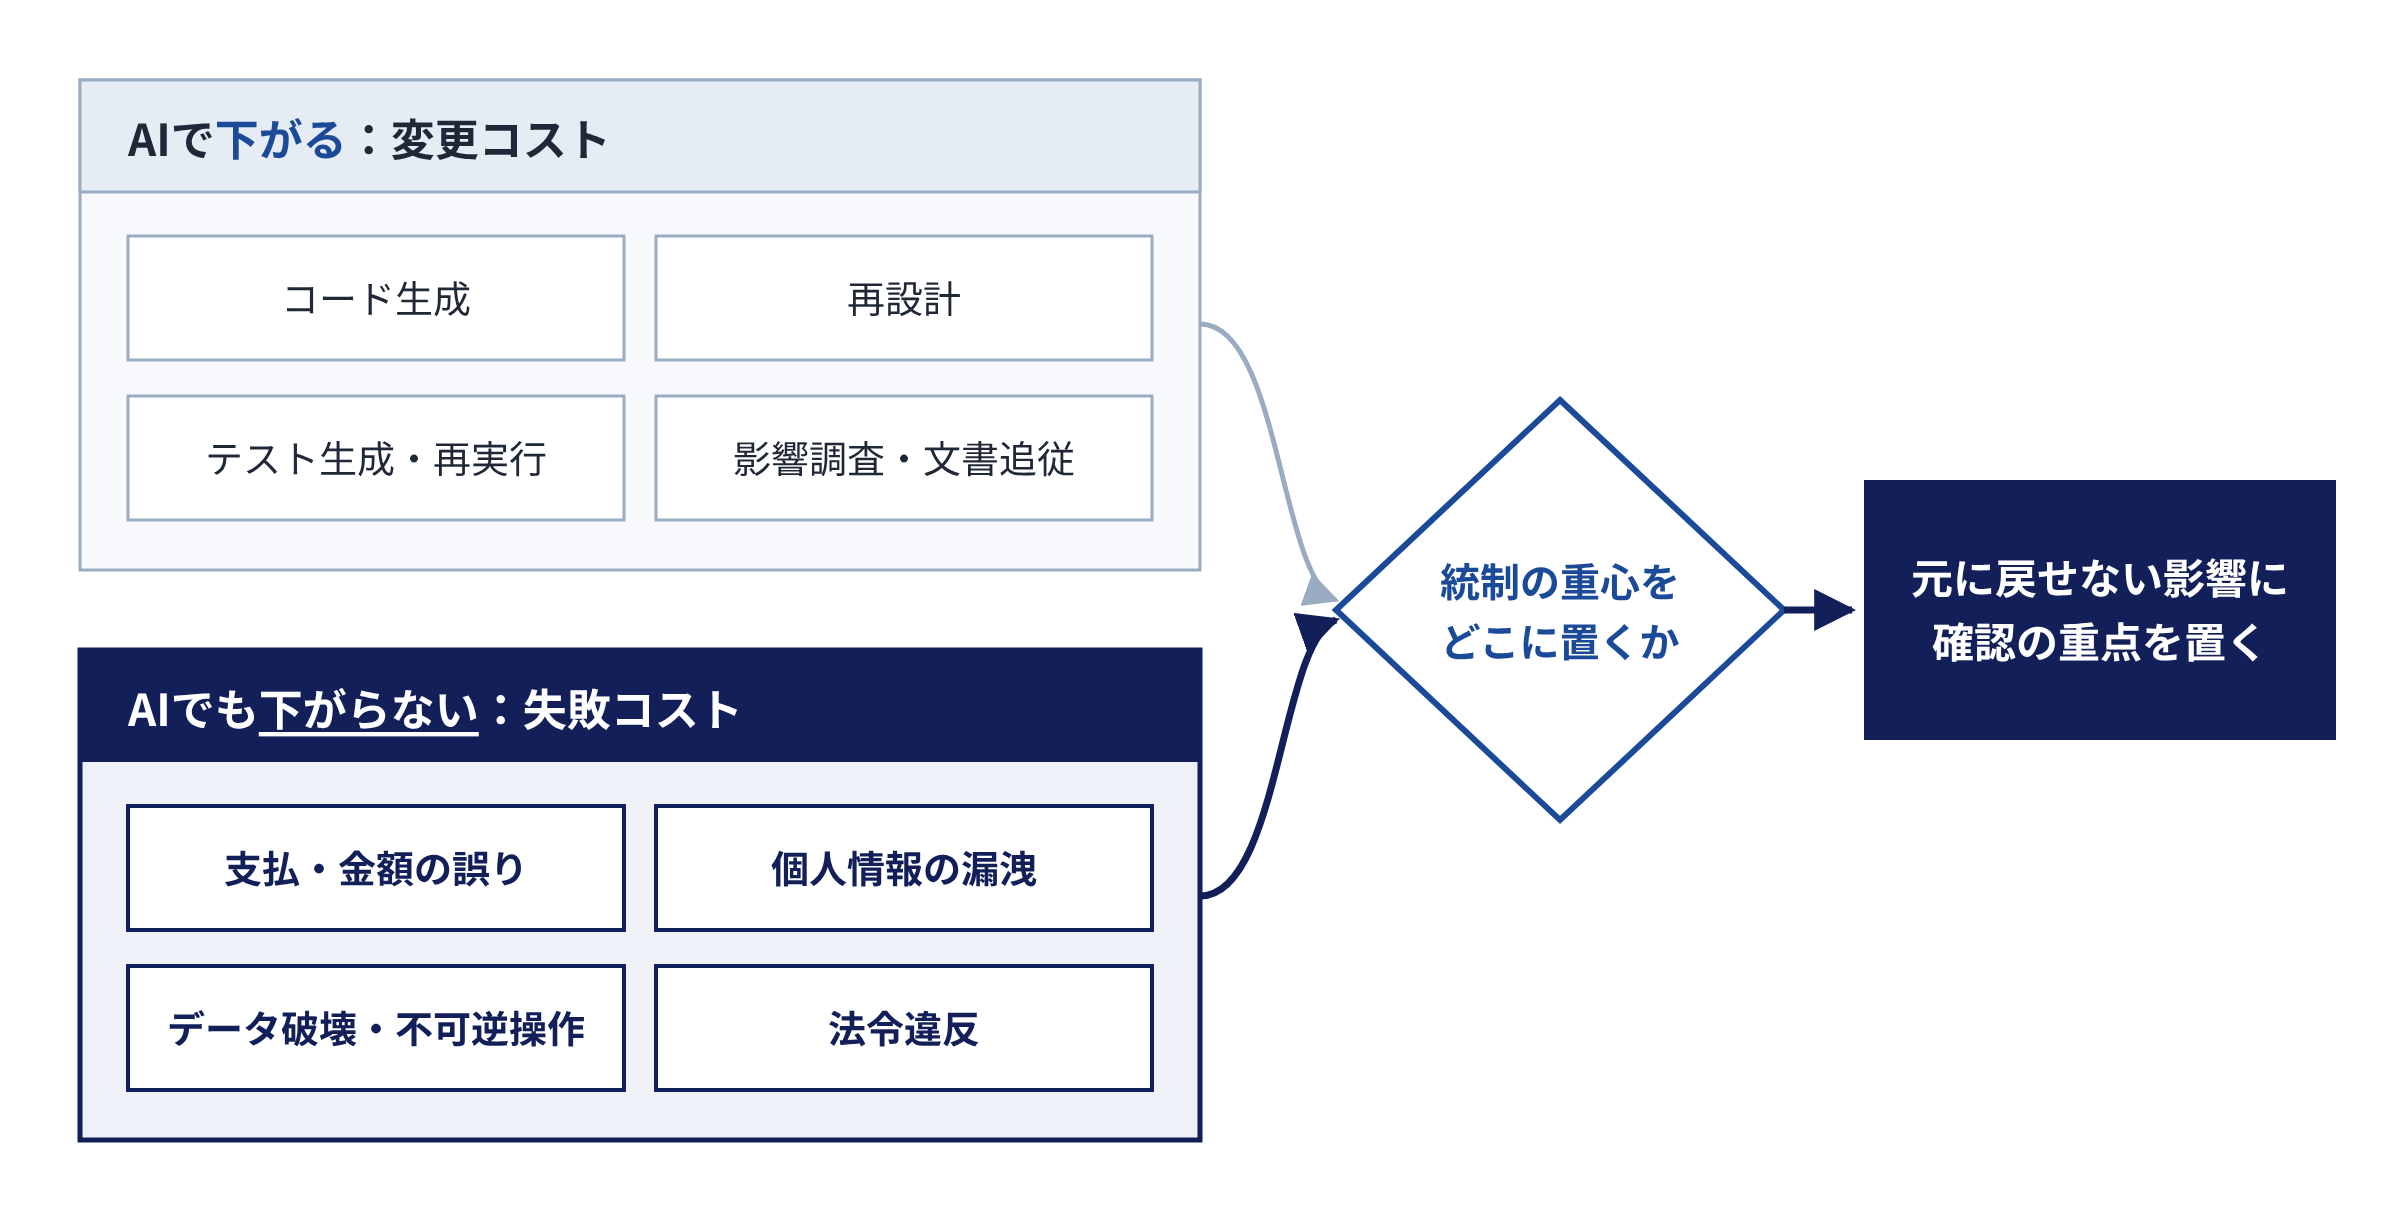
この2つを区別しないまま議論すると、答えは両極端に振れやすい。「AIで速くなったのだから品質管理も軽くしてよい」か、「AIは信用できないから、従来以上に全部を人が見る」か、である。
どちらも正しくない。問うべきは次のことである。
従来の品質管理が守ろうとしてきた目的を残したまま、その目的を実現する統制手段を組み替えられるか。
2. 目的と手段を切り分ける
従来の品質管理は、単なる「テスト」ではない。守ろうとしてきたものは、大きく次の8つに整理できる。
|
目的
|
従来の代表的な手段 |
|---|---|
| 要求の正しさ・完全性 | 要件定義、要求レビュー、受入テスト |
| 手戻り・修正コストの抑制 | 上流レビュー、フェーズ分割、工程ゲート |
| 重大リスクの抑制 | リスクベーステスト、脅威分析、FMEA |
| 実装の正しさの検証 | 各レベルのテスト、静的解析、コードレビュー |
| 変更影響の統制 | 変更管理、回帰テスト、構成管理 |
| 独立性・客観性 | 検証組織の分離(QA部門)、第三者・独立検証(IV&V等) |
| 保守性 | コーディング規約、設計レビュー、文書化 |
| 説明可能性・追跡可能性 | 要求ID、変更票、レビュー記録、テスト証跡 |
右列に挙げた手法の多く(独立検証〈IV&V〉、双方向の追跡可能性、リスク管理など)は、高い信頼性が求められる分野で体系化されてきたものである(※1)。
ここで大事なのは、右の列は目的ではないということである。
「コードレビューを実施する」ことが目的なのではない。目的は「実装上の誤りや設計上の問題を、作った本人とは異なる視点で見つける」ことである。同じように、「要件を凍結する」ことも目的ではない。目的は「要求の正しさを確保し、変更の影響を把握する」ことである。
AI時代の品質管理を考える出発点は、次の一文に尽きる。
品質の目的は残し、統制の方法を疑う。
3. 現場で実際に起きたこと
理屈の上では前章の表のように整理できる。しかし、私たちがこう考えるようになったのは、実案件で次の3つの現象を観察したからである。
本稿の観察は、2025年以降に私たちが関わった開発(業務システムの新規開発と既存システムの改修、規模はおおむね20人月以上、主な言語はJava/TypeScript、契約形態は請負)にもとづく。いずれも本稿冒頭で述べた、複数の組織が関わる中規模から大規模の開発である。個別の案件を特定できる情報は記さない。
3.1 開発フェーズでは、バグ件数という指標が機能しにくくなった
従来、品質の状況は「バグの発生件数が収束していく曲線」で語られることが多かった。
ところが、AIが実装し、ビルドや規約チェック、単体テストを自動で通過させてから人の手に渡る体制では、人間が受け取る時点で、自動ゲートが検出できる種類の単体レベルのバグはほとんど残っていない。数えるべきバグが出てこないため、開発フェーズの内部では収束曲線が描けない。ただし、これは自動テストの質に依存する観察であり、バグが存在しないことの証明ではない。この点は3.3節で改めて扱う。
誤解のないように付け加えると、収束曲線という考え方そのものが無効になったわけではない。QA組織による第三者試験のように、開発から独立した立場でシステム全体の品質を監視し、収束を予測する場面では、引き続き有効である。機能しにくくなったのは、開発フェーズの内部で、単体テストレベルのバグ件数を品質の進捗として読む使い方である。
逆説的だが、バグが出ないからこそ「では、どうやって品質を担保しているのか」が、かえって厳しく問われるようになった。テストレポートの充実が求められるのも、本質はここにある。
3.2 ボトルネックがレビューへ移った
上流工程と実装をAIで加速すると、成果物が生まれる速度に人間の確認が追いつかなくなる。開発全体のボトルネックは「作ること」から「確かめること」へ移った。同様の傾向は、業界の調査でも報告されている。GitLab社が委託した意識調査(6か国・1,528人)では、AIによってボトルネックがコードを書くことからレビューと検証へ移った、と85%の回答者が答えている(※2)。
このとき、レビュアーを増やしても解決にはならない。私たちが採った対策は、レビューの観点を事前にAIに与え、レビューそのものを効率化することだった。同時に、人間が見る対象を「コードが正しいか」から「仕様が正しく実現されているか」「要件そのものが正しいか」へ移した。
3.3 AIは「通るだけのテスト」を書く
AIに実装とテストの両方を任せると、ときに何をしても失敗しないテストが混じる。AIは「テストしました」と答えるが、そのテストは何も検証していない。
これは、AIの能力不足というより構造の問題である。AIは、人間が本当に望んでいることではなく、与えられた「観測できる成功基準」を満たす方向に最適化される(※3)。「テストが通ること」が成功基準であれば、通るテストを作る。
テストに通ることと、実務で受け入れられる品質とが一致しないことは、外部の検証でも示されている。3つのオープンソースプロジェクトで、ベンチマークの自動テストに合格したAIエージェントの修正を保守者が審査したところ、コードの品質面も含めて判断すると約半数はマージされない水準だったという(※4)。
興味深いことに、別のコンテキストで動く別のAIにレビューさせると、「失敗できないテストはテストではない」という観点を自力で見つけ出した事例があった。評価する主体を生成のループの外に置けば、この種の問題を検出できる可能性があるということである。
4. 再設計の5つの柱
以上の観察を踏まえ、私たちは品質管理を次の5つの柱で組み替えている。
4.1 工程の区切りではなく、作業単位ごとに品質を確かめる
従来は、要件定義、設計、実装、テストという工程の区切りに、正式な品質の確認点を置いてきた。もちろん、工程の途中でも「作業単位ごとに確かめる」ことは指示されてきた。単体テストを書く、セルフレビューをする、規約に沿っているか確かめる。作業者への依頼としては、どの現場にもあったはずである。
しかし、忙しい工程の中で、その確認を毎回同じ深さで行い、記録まで残すことは、人の努力だけでは難しかった。基準の解釈には幅があり、繁忙期には省略されやすく、実施したという記録も残りにくい。これは個人の姿勢の問題ではなく、人が担う確認の構造的な限界である。だからこそ、工程の区切りに正式なゲートを置き、まとめて確かめ直す必要があった。
AI駆動開発では、この前提が変わる。ひとつの機能追加や修正について、設計・コード・テストの更新から検証までを短いループで回せる。しかもそのループでは、ビルド・規約チェック・テストのような機械的な検査は毎回同じ基準で適用され、AIによるレビューも含めて実施した記録が必ず残る。人の作業者に依頼しても徹底できなかった「作業単位ごとの確認」が、はじめて仕組みとして成立する。したがって、品質を確かめる単位を工程から作業単位へ移すことが、現実的な選択肢になる。小さな単位で作業し、素早くフィードバックを得ることは、AIを取り入れる組織でいっそう重要になるとも指摘されている(※5)。
ここでいう作業単位とは、ひとまとまりの機能追加や修正を指す。実務上は、原則としてプルリクエストの粒度である(一つのプルリクエストに複数のコミットを含む)。工程がすべて終わるのを待たず、作業単位ができあがるたびに品質を確かめる。
なお、エージェント中心の開発を実践するOpenAIは、エージェントの処理量が人間の注意力を大きく上回る環境では、マージを止めるゲートをむしろ最小限にし、「修正は安く、待つことは高くつく」(筆者訳)という判断を示している(※6)。本稿が想定する受発注型の開発では、処理量よりも説明責任が先に立つため、この前提はそのままでは成り立たない。作業単位ごとに確かめるという点は同じでも、ゲートを緩める方向ではなく、ゲートの記録を証拠として残す方向に重心を置く。
私たちはこれを「品質ゲート」として実装している。AIが生成したコードは、次の段階をすべてのエラーが解消されるまで自動で繰り返し通過しなければならない。
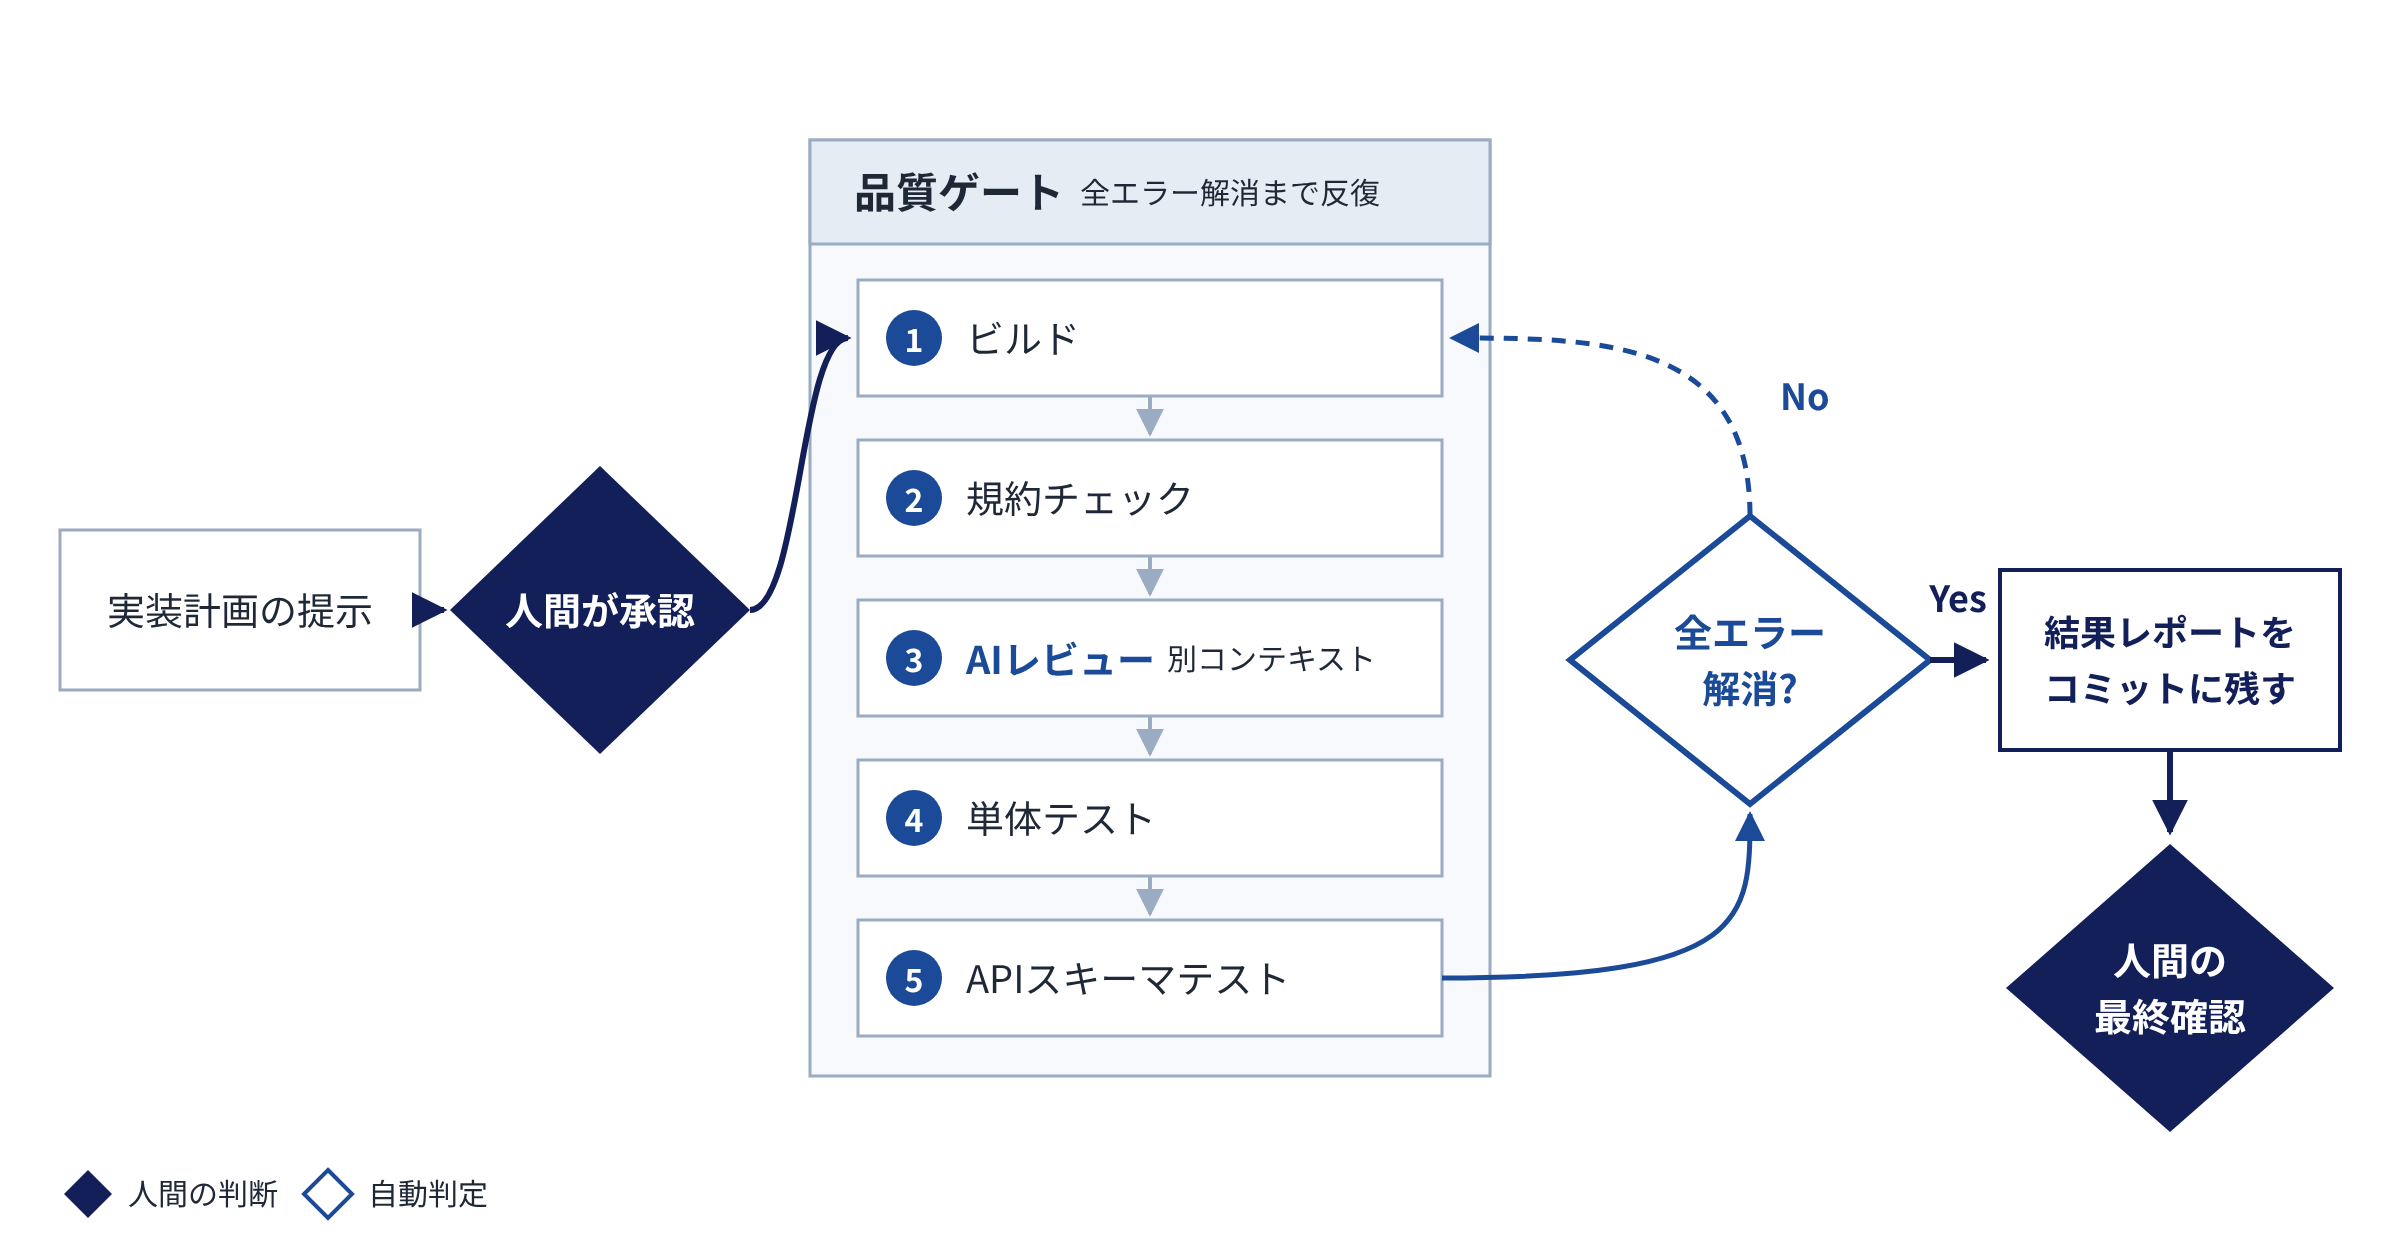
このゲートの設計思想は「治療ではなく予防」である。バグを見つけて直す体制を厚くするのではない。規約違反やビルドエラーを含むコードが、そもそも次へ進めない構造を作る。
ただし、ループを無制限に回すわけではない。繰り返しの回数には上限を設け、上限に達した作業単位は人間に差し戻す。また、テストや受入基準のファイルは、生成するAIが書き換えられないように分けて管理する。ゲートを通すためにテストを弱める、という抜け道を塞ぐためである(4.2節の「権限の独立」)。
もう一つ、あまり語られない本質がある。ゲートの強さは仕組みの巧妙さでは決まらず、参照させる実装ガイドラインや規約の質で決まるということである。したがって、ゲートを運用することは、ノウハウをAIが読める形で蓄積し続けることと同じ意味を持つ。
ただし、ゲートの強度は一律にしない。私たちは次のように使い分けている。
- 既存コードの改修:新規開発と同じ規約をかけると、既存部分が通らなくなる。そこで規約は修正箇所だけに適用する。
- CI上のE2Eテスト:失敗しても自動修正はさせない。「試験が通るようになったが、仕様と違う動きをしている」という状態を避けるためである。
同じゲートでも、対象コードの性質と実行する環境によって強度を変える必要がある。
作業単位に寄せすぎることの副作用:共通化が崩れる
ただし、作業単位ごとに確かめるという考え方を過度に推し進めると、別の問題が生じる。
作業単位ごとに生成と検証を完結させると、それぞれの単位は自分の中だけで正しく閉じようとする。その結果、本来は共通化すべき処理が、単位ごとに少しずつ異なる形で重複して実装されやすくなる。ログ出力、エラー処理、権限チェック、マスターデータの参照などが典型である。一つひとつの作業単位はゲートを通過していても、システム全体としては一貫性を失い、保守しにくくなっていく。局所的には正しいが、全体としては崩れている状態である。
これは、工程の区切りで行ってきた設計レビューが担っていた役割、すなわちシステム全体を横断して見る視点が抜け落ちることで起きる。したがって、作業単位へ移すのは「品質を確かめるタイミング」であって、工程そのものをなくすわけではない。横断的な判断は、引き続き工程の中で意図して行う必要がある。
私たちも社内でこの点を繰り返し議論してきた。現在は、各フェーズで次のように手当てしている。
| フェーズ | 共通化を崩さないための手当て |
|---|---|
| 要件定義・計画 | 共通部品に関わる非機能要件(ログ出力の方式、ファイル操作など)を最優先で決める。後から共通部品に組み込むのは難しいためである。共通機能は個別機能とは別に括って計画し、影響範囲の広さに見合った重みを置く |
| 設計 | 画面や機能ごとの設計書に加えて、共通設計書を置く。エラー処理や論理削除などは、機能ごとではなく横断ルールとして一つに定める。共通化の粒度とタイミングは設計段階のレビューで判断し、業務内の共通化と業務間の共通化を分けて考える |
| 実装の開始時 | 基本的なデータ操作(登録・更新・削除・検索)は、個別機能の実装に入る前に共通で用意する。複数のAPI仕様をまとめてAIに読ませ、共通部品を早い段階で抽出させる |
| 実装・検証 | 重複コードの検出やアーキテクチャ制約の検査を静的解析としてゲートに組み込む。共通部品の修正によって他の機能が壊れていないかを、CI上の回帰テストで検出する |
一方で、共通化は多ければ多いほどよいわけでもない。工数を減らす目的で細かく共通化しすぎると、一つの修正が広い範囲に波及し、運用保守がかえって難しくなる。どこまで共通化するかは、工数と保守性のトレードオフとして設計段階で線を引いておくべき判断である。
作業単位ごとの品質確認は、工程を通じた横断的な設計判断を置き換えるものではない。両者を組み合わせて、はじめて機能する。
4.2 生成と検証を分ける
3.3節で見たとおり、同じAIが要求を誤解し、その誤解のままコードとテストを書けば、テストは当然通る。したがって重要なのは、「テストが通ること」ではなく、正解の根拠が生成する側から独立していることである。候補を生成し、あらかじめ定めた検証条件を満たしたものだけを採用するという考え方は、Metaの研究でも「生成と検証」の枠組みとして提案されている(※7)。
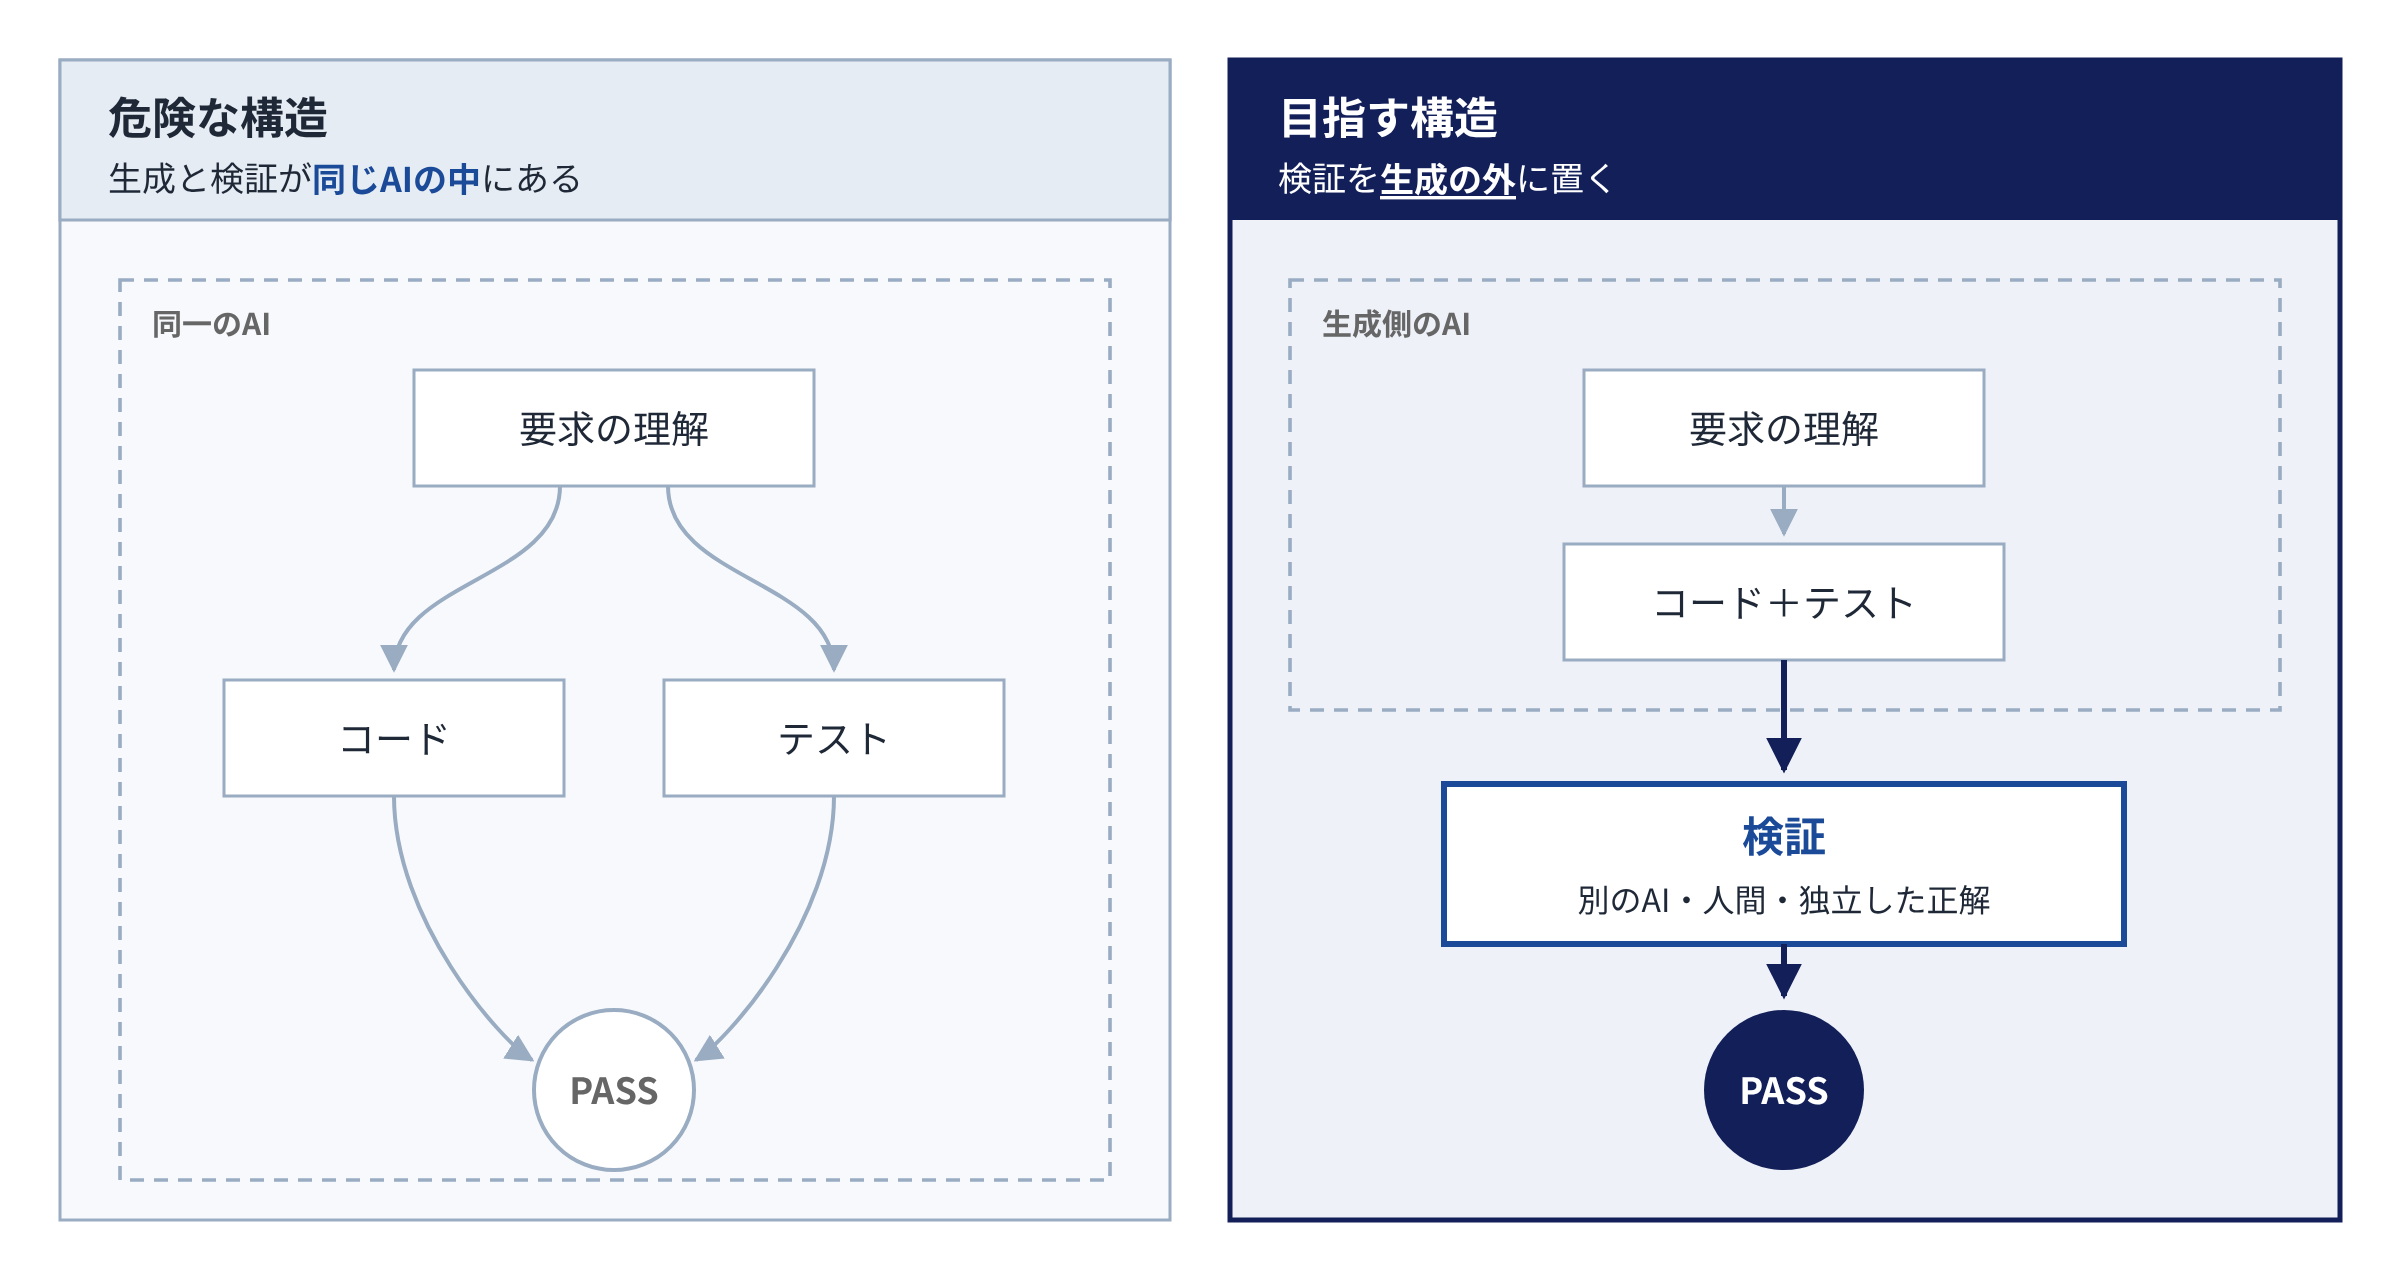
「危険な構造」では、要求の理解を誤れば、コードもテストも同じ誤りを共有したままPASSする。「目指す構造」では、生成側の理解に依存しない検証が間に入るため、同じ誤りがそのまま通過する可能性を下げられる。ただし、検証側も同じ系統のモデルであれば誤りを共有しうる(7章)。
本稿で「独立した検証」と呼ぶのは、次の3つの層のうち少なくとも「正解情報」と「評価方法」の2つを満たす検証を指す。独立性は、少なくとも3つの層で考える必要がある。
- 正解情報の独立:既存システムのテスト、人間が書いたシナリオなど、生成AIが作っていない正解を持つこと。
- 評価方法の独立:コンテキストもモデルも分けたレビュー用エージェントを置き、静的解析のような機械的検査を併用すること。
- 権限の独立:生成するAIが、受入基準やテストシナリオを書き換えられないようにすること。
AI自身による内部の検証とは別に、独立した検証役を外部の統制として置くという考え方は、国内の品質保証コミュニティでも議論されている(※8)。さらに踏み込んで、人間がコードを書かずレビューもせず、コードベースの外に置いたシナリオと自動評価によって品質を確かめる「ソフトウェアファクトリー」を提唱する例もある(※9)。本稿はそこまでは振り切らず、重要な判断には人間のレビューを残す立場を取る。
加えて、AIが見落とした観点を人間が補った場合は、その観点を記録してAIへの入力に加え、次回以降は最初から考慮させる。人間の知見を一度きりの指摘で終わらせず、再利用できる資産に変えていくためである。
ただし、このフィードバックには異論もあり、無条件に進めてよいものではない。指摘のたびに観点や禁止事項を足し続けると、AIへの入力は際限なく膨らむ。互いに矛盾する指示が混じり、AIの挙動はかえって不安定になる。さらに、積み上がった指示群を保守すること自体が新たな負担になる。その行き着く先は、あらゆる制約に縛られて自ら何も判断できなくなったAIである。これは、判断の軸を人間が持ち、作業をAIに任せるという本来の目的から外れている。フィードバックすべきなのは個々の修正内容ではなく、繰り返し現れる観点や考え方に限るべきである。何を戻し、何を戻さないかの選別も、人間が担う判断の一つと考えたほうがよい。
そして、品質を確かめる形式そのものも単純化できる。人間が重要な論点を問いとして設定し、AIにそれへ答えさせる。 人間が持つのは問いの設計であり、回答の生成はAIに任せる。
4.3 リスクに応じてゲートの強度を変える
すべての作業単位を同じ重さで審査する必要はない。むしろ、作り直しのコストが下がった今こそ、作業単位ごとの重さに応じて統制の強さを変えるべきである。
作業単位の重さは、少なくとも次の5つの観点で評価できる。
- 失敗したときの被害の大きさ(Impact)
- 影響の範囲(Blast Radius)
- 元に戻せるかどうか(Reversibility)
- 問題が起きたとき、すぐに気づけるか(Detectability)
- 仕様や影響範囲がどれだけ不確かか(Uncertainty)
これらを組み合わせると、たとえば次のような段階を置ける。
| クラス | 例 | 統制 |
|---|---|---|
| R0 低 | 文言、軽微なUI | 自動検証のみ |
| R1 通常 | 一般的な機能 | CI+独立したAIによる検証 |
| R2 高 | 認証、課金、主要データの更新 | 強化した検証+人間のレビュー |
| R3 重大 | 大規模移行、不可逆な金銭処理 | 独立した検証+明示的な承認 |
ここで強調したいのは、確認の重点をどこに置くかという判断基準の変化である。
修正が安価になれば、手戻りの大きさで確認の濃淡を決める意味は薄れていく。人間の確認を振り向けるべきなのは、一度起きてしまえば元に戻せない影響と、越えてはならない一線を守るための領域である。典型的には、次のようなものが挙げられる。
- 金銭の授受や計算に関わる処理
- 個人に紐づく情報の取り扱い
- 認証や権限管理などのセキュリティ機能
4.4 「活動」ではなく「証拠」で品質を示す
従来の品質保証では、「設計レビューを実施した」「テスト工程を完了した」という活動そのものが証跡になりやすかった。AI時代に求められるのは、次のような機械的な証拠である。
- この要求は、このシナリオで検証された。
- この修正は、この規約とこのテストを通過した。
- このAPIは、この再現コマンドで同じ結果が得られる。
私たちは、品質ゲートの最後に「動作確認と再現コマンドを含む結果レポート」を出力させ、生成の直後に必ずコミットしている。テスト仕様はテストコード自体で表し、結果はカバレッジやサマリーのレポートとして自動生成する運用を基本としている。
ただし、証拠を集めるだけでは足りない。実践を通じて私たちが最も強く感じているのは、次の点である。
品質を語れるかどうかは、比較の基準を持てるかどうかで決まる。
既存システムの改修では、既存のソースコードとテストという「正解」がある。そのため、AIが再現した結果との差分を、移植率や未移植項目として明確に示せる。正解がすでに存在するものを題材に検証を設計すれば、精度の議論は主観の水掛け論にならない。
これに対し、新規開発では比較対象がない。過去の同種案件のバグ件数のデータがなければ、「従来と同水準以上の品質である」と示す手段がない。現状では、結局のところ人間が全量を確認し、見た者が妥当と判断するほかない。何と比べて品質を語るのかを、検証を設計する段階で決めておくことが必要である。
証拠の「見せ方」も、品質管理の一部である。
- 数字は流れの中で示す:その場の数字を示すだけでは足りない。「どういう観点で何を確認してきた結果、この数値になっているのか」という流れの中で示す必要がある。判断の基準は、プロジェクトの事情をまったく知らない第三者が、その数字を見て納得できるかである。
- 中継者を想定する:品質報告の受け手は、多くの場合、最終読者ではなく中継者である。発注側の担当者が、その先の顧客へ端的に説明できる形になっているかまで想定して、報告の形式を決める。
4.5 人間にしかできない判断へ集中させる
AIに任せられるのは作業である。確認や検証が妥当かどうかを見ることは、人間に残る。 人間が握り続けるべきなのは、次のような判断である。
- 何を実現するのか(意図)
- 何を優先するのか(価値)
- どこまでの失敗を許容するのか(リスク許容度)
- 正解が一つでないとき、どう判断するのか(曖昧さの解消)
- 通常のルールから外れることを認めるか(例外)
- 失敗した場合の影響が甚大な判断(重大な承認)
複雑な不具合への対応も、同じ考え方で扱うことができる。原因の調査と修正方針の立案まではAIに任せ、どの方針で直すかの決定は人間が行う。業務知識を持たないAIが、推測を重ねたまま修正を完了させてしまうことを避けるためである。
ここで見落としてはならないのは、AIが業務知識を持たないという事実は、人間が判断を握る理由であると同時に、人間が業務知識をAIに渡す責任を負うことも意味する点である。AIの判断の質は、与えられたコンテキストの質で決まる。業務ルール、例外条件、過去の経緯、顧客固有の前提。これらを、AIが読める形のコンテキストへ落とし込む仕事は、これまで以上に重要になる。人間の役割には「判断すること」だけでなく、「判断の材料となる業務知識を、AIが使える形に整えること」が含まれる。4.1節で述べた「ゲートの強さは参照させる知識の質で決まる」という点と、根は同じである。
人間の役割は、「成果物を一つずつ検査する人」から、「品質保証の仕組みそのものを設計し、例外と重大な判断を担う人」へ移っていく。これはエンジニアの仕事が楽になるという話ではない。高い品質の基準を知らなければ、問いを立てることもレビューすることもできない。求められる水準は、むしろ上がる。
5. 仕組み化への移行ステップ(提案)
ここまで述べたのは、いわば到達点の姿である。実際の開発で、明日からいきなりそこへ移れるわけではない。AIの生成物を無条件に信頼できるだけの実績と方法論は、まだ業界全体としても確立していないからである。
一方で、理想形が固まるのを待っていては、目の前のプロジェクトの品質管理を始められない。そこで私たちは、到達点から逆算した段階的な移行を提案する。各段階で何を確認し、何が揃えば次へ進むのか。その条件をあらかじめ明示しておくことが要点である。
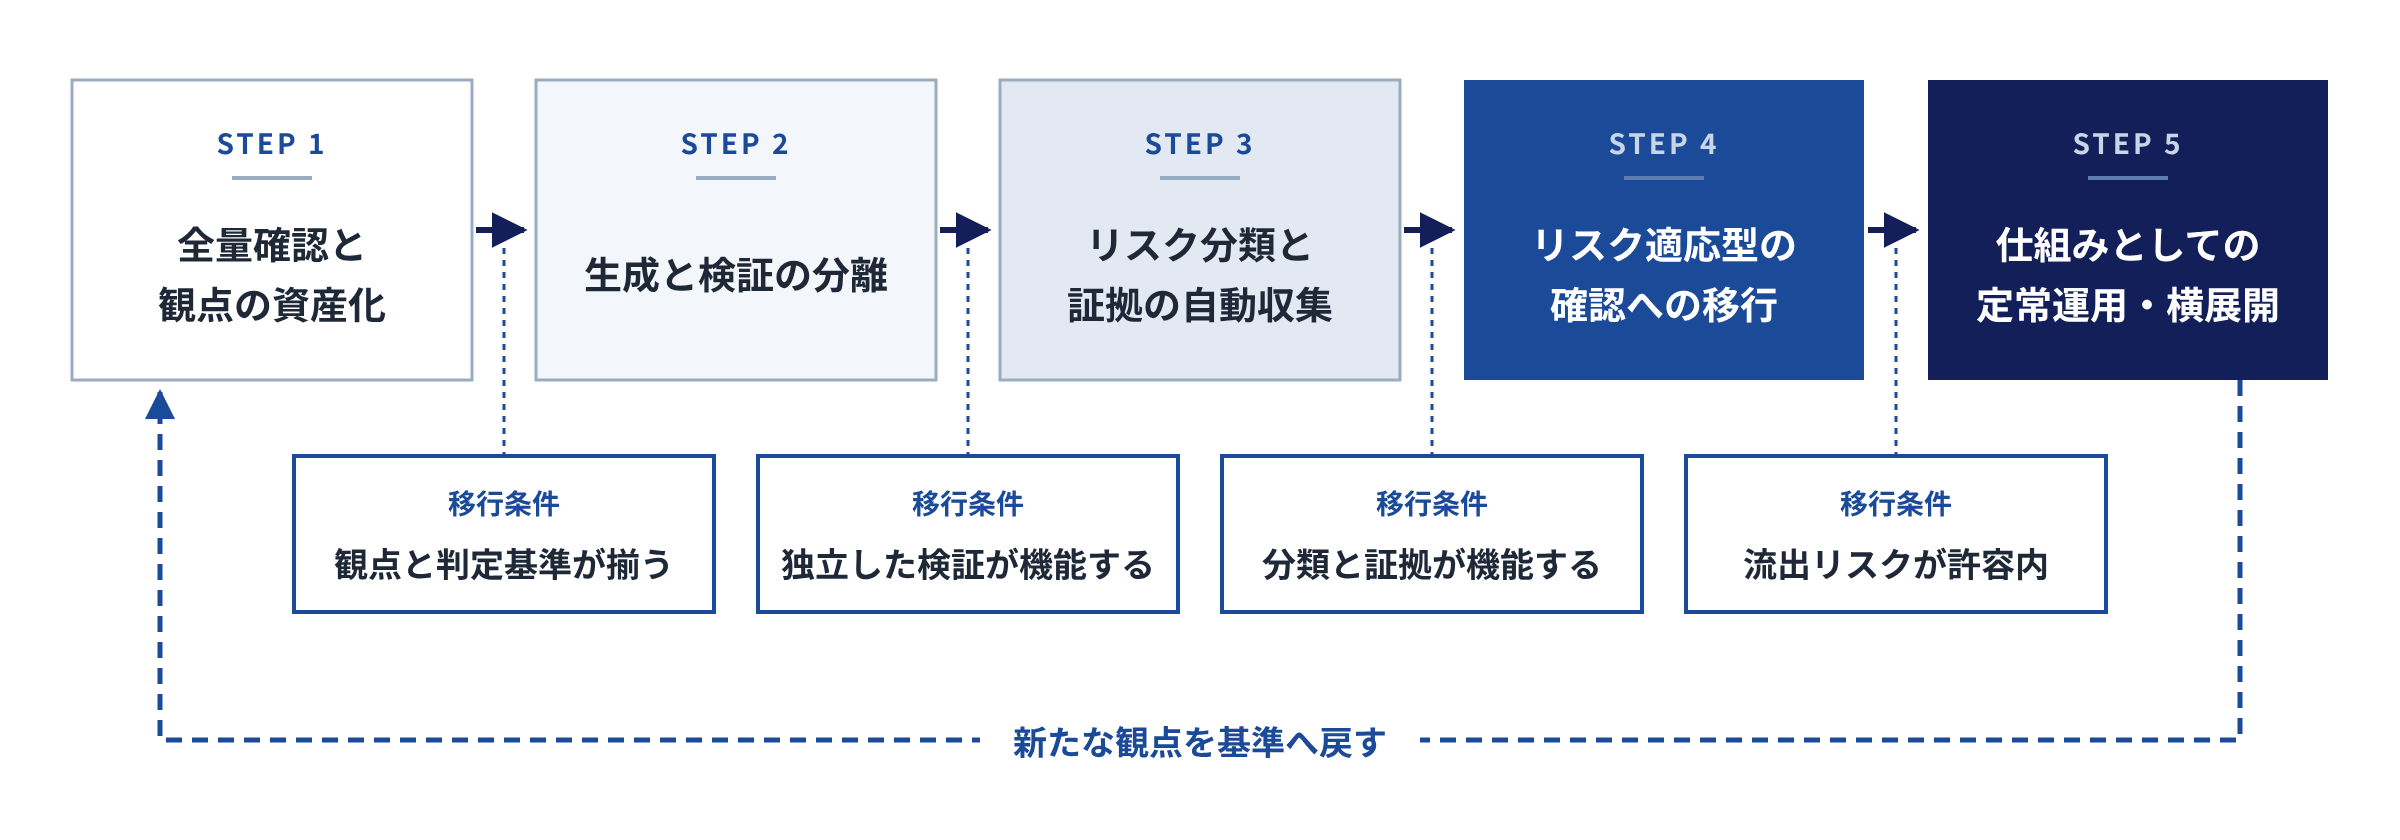
Step 1:全量確認と、観点の資産化
最初の段階では、AIが生成したものを全量、人間が確認する。ただし、この段階の目的は「全部を人が見ること」そのものではない。人間がどこを見て、何を指摘したのかを記録し、観点として資産にしていくことにある。
- AIの生成物に対して人間が追加した観点を記録する。そのうち繰り返し現れる本質的な観点に絞って、AIへの入力として戻す(4.2節で述べたとおり、過剰なフィードバックは避ける)。
- レビューの指摘を分類し、どの種類の問題が、どの領域で、どの頻度で見つかるのかを蓄積する。
- 品質ゲートの規約やガイドラインに、見つかった観点を反映していく。
次へ進む条件:レビューの観点がチェックリストや評価基準として明文化されていること。さらに、「どの領域では人間の確認で問題が見つからなくなったか」を、記録にもとづいて示せること。
Step 2:生成と検証の分離
第二段階では、4.2節で述べた構造を実際に組み込む。Step 1で資産化した観点は、この段階で「検証側」の材料になる。
- 実装を担うAIとは別に、コンテキストもモデルも分けた検証用のエージェントを置く。Step 1で明文化した観点と評価基準を、生成側ではなく検証側に与える。
- 生成AIが作っていない正解を用意する。既存システムのテスト、人間が書いたシナリオ、静的解析のルールなどである。
- 受入基準やテストシナリオを、生成AIが書き換えられない場所に置く。
- この段階でも人間の全量確認は続ける。ただし、独立した検証が見つけた問題と、人間が見つけた問題を突き合わせ、検証側がどこまで人間の代わりになりうるかを記録していく。
次へ進む条件:人間の確認で見つかる問題の大半が、独立した検証でも検出できていること。逆に言えば、人間にしか見つけられない問題の種類が特定できていること。
4.4節で述べたとおり、新規開発には既存システムのような「正解」がない。その場合は、この段階で得られる「人間の指摘と独立した検証の一致率」を、比較の基準の代わりに使う。正解との差分ではなく、検証が人間の目にどこまで追いついたかを根拠にして、次の段階へ進む。
Step 3:リスク分類と、証拠の自動収集
第三段階では、作業単位をリスクで分類する基準を定め、品質の証拠を自動で残す仕組みを整える。
- 4.3節の観点(被害の大きさ、影響範囲、元に戻せるか、検知のしやすさ、不確かさ)をもとに、リスク分類の基準を定める。金銭処理、個人に紐づく情報、セキュリティ機能のように影響を元に戻せない領域は、重点対象として別に定めておく。
- テスト結果、ゲートでの修正履歴、使用したモデル、人間の承認を、作業単位ごとに自動で記録する。
- 全量確認はまだ続けるが、それと並行して、リスク分類にもとづく重点確認を試行する。全量確認の結果と重点確認の結果を突き合わせ、分類の妥当性を検証する。
次へ進む条件:低リスクに分類された領域で、全量確認をやめて重点確認だけにしても、全量確認と同じ結論になることが、一定期間にわたって示されていること。
Step 4:リスク適応型の確認への移行
第四段階で、はじめて全量確認を外す。低リスクの作業単位は自動検証と独立したAIの検証に任せる。人間は、高リスクと重大リスクの作業単位、そして例外の判断に集中する。
- R0・R1は自動検証とStep 2で整えた独立した検証を中心とし、人間は抜き取りで確認する。
- R2・R3は、強化した検証と人間のレビュー、明示的な承認を必須とする。
- 本番での不具合の流出を、件数ではなく重大度で重み付けして監視する。分類の誤りが見つかれば、基準を直ちに見直す。
次へ進む条件:重大度で重み付けした流出リスクが、組織として定めた許容範囲に収まっていること。
Step 5:仕組みとしての定常運用と横展開
最終段階では、リスク分類、ゲートの強度、必須とする証拠をルールとしてコード化し(Policy-as-Code)、プロジェクトごとの属人的な判断に頼らずに運用できる状態にする。ここまで来て、品質管理は個々の案件のやり方ではなく、組織の仕組みになる。他の案件へ展開するときも、どこを案件ごとに調整すべきかを明示したうえで、同じ基盤の上に載せられる。
移行期間を通じて守るべき原則
どの段階にあっても、次の3つの原則は変わらない。
第一に、確認の網羅性を効率より優先する。 確認の担当範囲を効率よく切り分けようとすると、担当と担当の境目に、誰も見ていない領域が生まれやすい。AIへの信頼がまだ確立していない段階では、複数の主体の確認範囲が一部重なることを無駄と捉えるべきではない。むしろ保険と考えるべきである。確認を絞り込むのは、上に示した移行条件を満たしてからでよい。
第二に、網羅的な確認と重点的な確認を、別の主体が担う。 受発注の関係がある開発では、成果物全体をひととおり確認する責任は作り手が負い、そのうえでどこを深く掘り下げるかは受け手が判断する、という二層の構造が有効である。ここでいう「成果物全体の確認」とは、すべての作業単位が品質ゲートを通過し、その記録と結果レポートが揃っている状態を、作り手が示すことである。どこを重点的に見るべきかについては、作り手が候補とその理由を示し、両者で合意する。ただし、受け手は作り手が示した候補以外からも無作為に抜き取って確認する。作り手が見てほしくない箇所を候補から外せる、という構造を残さないためである。あわせて、受入基準と受入シナリオは受け手が所有し、作り手のAIはそれを書き換えられないようにする。4.2節で述べた「権限の独立」を、受発注の関係にも当てはめた形である。
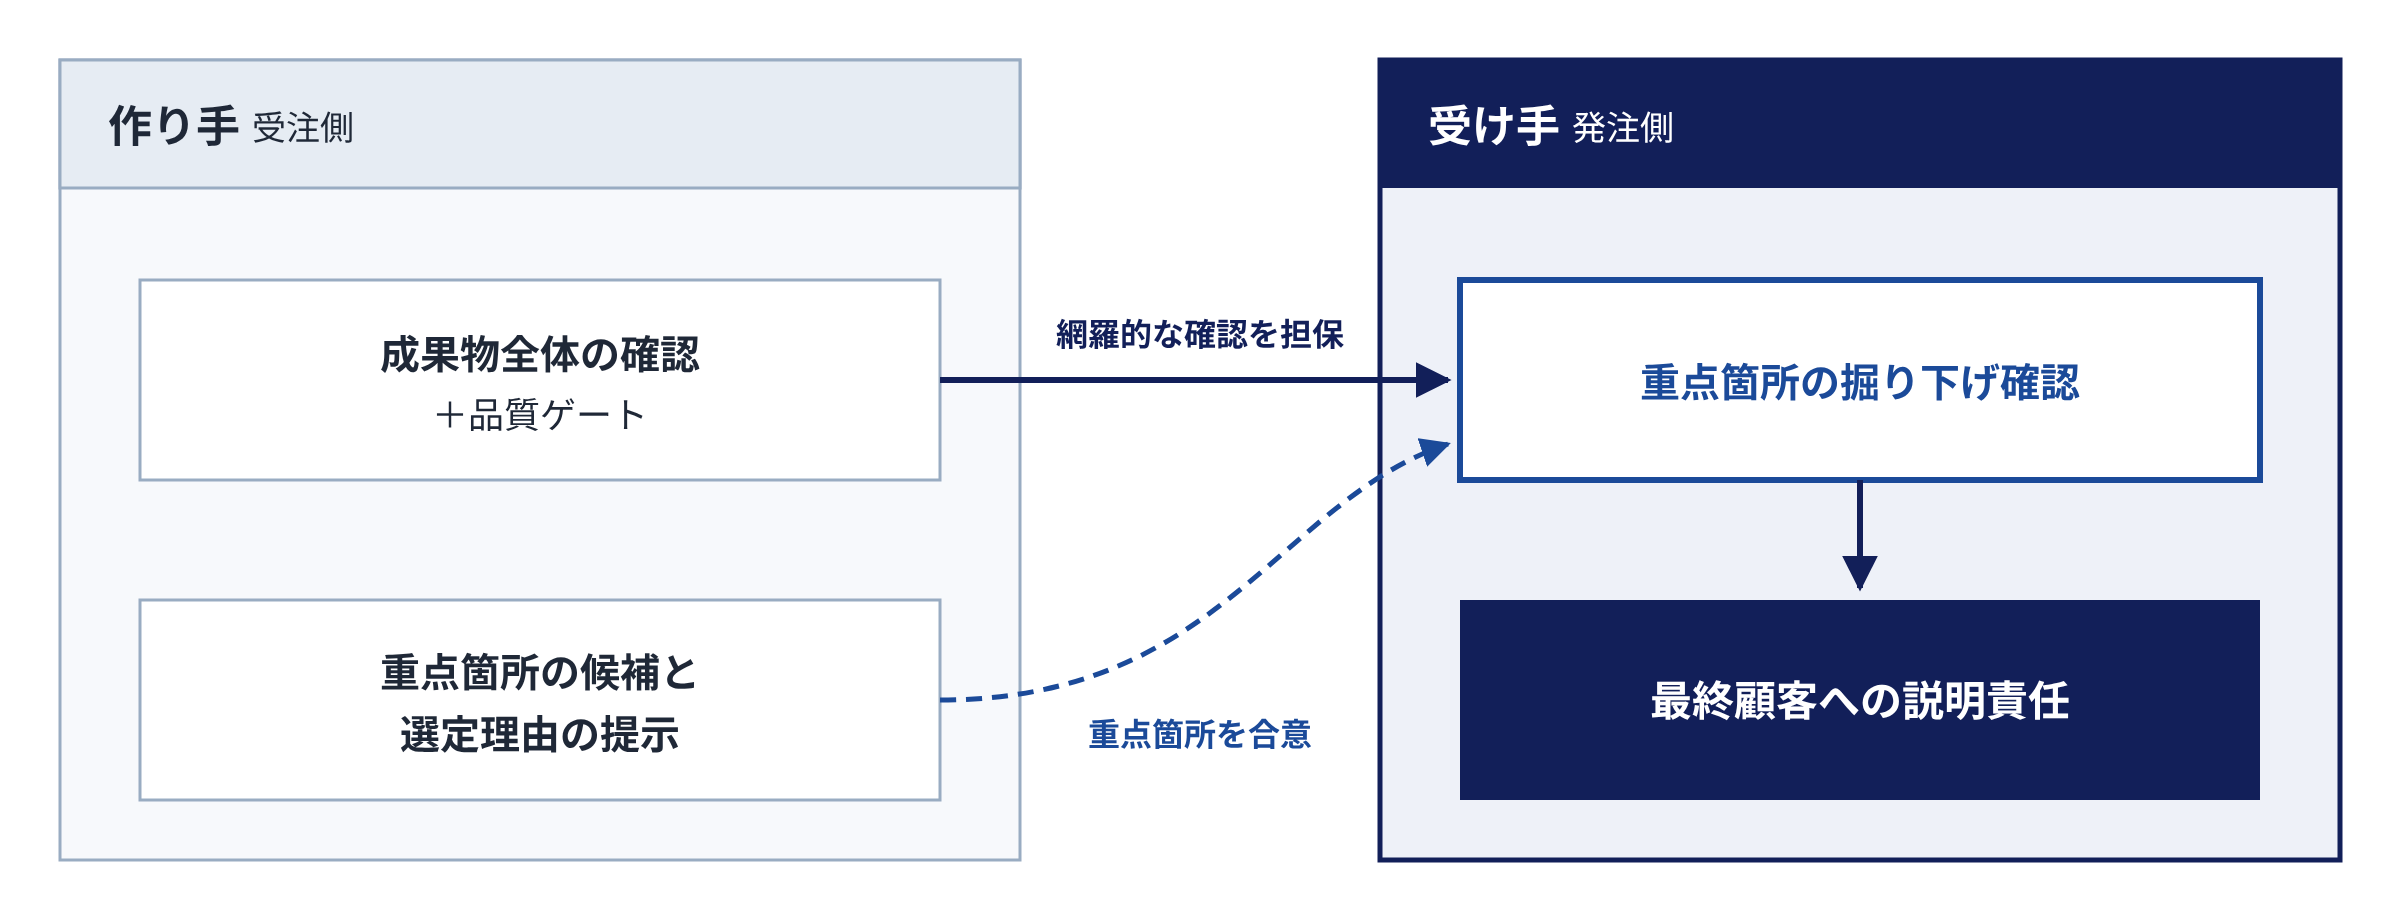
重点箇所の候補を示すときは、対象の一覧そのものよりも、なぜそれを選んだのかの言語化に価値がある。業務上の重要度や、機能どうしのつながりの中での位置づけから候補を選び、その理由を説明できることが、提示の本体である。
第三に、確認の仕方を変えるときは、その根拠を説明できる形で示す。 最終顧客に説明責任を果たすには、作り手の申告に加えて、受け手が自ら確かめられる手段が欠かせない。したがって説明には、AIを使った開発で確認の重点を移す理由と、各段階で次へ進んでよいと判断した根拠が含まれている必要がある。
確認を段階的に減らしていくことは、品質を緩めることではない。品質保証の論理を組み替え、その根拠を示しながら一段ずつ進めることである。
6. 指標をどう置き直すか
3.1節で述べたとおり、開発フェーズの内部でバグ件数の推移を品質の進捗として読む方法は、機能しにくくなった。では何を見るのか。現時点での私たちの考えを示す。
先に、指標を考えるうえでの前提を一つ置いておきたい。品質の指標と、開発効率の指標は別物である。 AI駆動開発を語るとき、この二つは混ざりやすい。しかし、プロダクトの責任者がリリースを許可するとき、根拠にするのは「速く作れたか」ではなく「正しく動くと示せるか」である。本章では、この二つを分けて扱う。
6.1 見直しが必要な従来の指標
- 開発フェーズ内でのバグ件数と収束曲線:3.1節で述べたとおり、開発の内部で単体テストレベルのバグを数えても、品質の進捗を表さなくなった。第三者試験など、独立した立場からシステム全体を監視する場面では引き続き有効である。
- 工程の完了率、設計書の完了率:活動の量を示すにすぎず、品質の証拠にはならない。
- テストカバレッジの目標値:人手でテストを書いていた時代には、工数との兼ね合いから、8割から9割程度を現実的な目標とすることが一般的だった。たとえばGoogleは、60%を「許容できる」、75%を「称賛に値する」、90%を「模範的」とする目安を示しつつ、100%に近づけることに注力すると誤った安心感につながる、と警告している(※10)。本稿もこの警告に同意する。テストの作成も実行もAIと自動化が担うのであれば、工数を理由にした妥協を続ける必要は薄れ、単体テストについては限りなく100%に近い目標を置くことが現実的になる。ただし、環境に依存する処理や、技術的な制約から到達できない、あるいは到達すべきでない箇所は必ず存在するため、100%そのものを目標にすべきではない。そして、カバレッジを上げる価値があるのは、そのテストが実際に失敗しうる場合に限られる。何をしても通るテストでカバレッジを上げても意味はなく、カバレッジの目標は4.2節で述べた検証の独立性とセットで運用する必要がある。
6.2 品質を示す指標
品質そのものを表す指標の候補を挙げる。いずれも「正しいと示せるか」に直接関わるものである。
- 自動検証の網羅率:重要な要求のうち、自動化された検証で確かめられているものの割合。要求ごとに「どの検証で確かめたか」が紐づいて、はじめて意味を持つ。
- 独立した検証による検出率:人間の確認で見つかった問題のうち、独立した検証(別のAI、静的解析、独立した正解との照合)でも検出できていたものの割合。第5章のStep 2で、検証がどこまで人間の代わりになりうるかを測る指標でもある。
- 重大度で重み付けした流出不具合:本番へ流出した不具合を、件数ではなく重大度で重み付けして評価する。バグ件数に代わる、結果としての品質指標である。
- 追跡の完全性:要求から設計、実装、テスト、リリースまでを途切れなく追跡できる割合。証拠が揃っているかどうかを表す。
- 再現率・合致率:既存システムの改修では、移植できたテストケースの割合や、設計書と元の設計との合致率を使える。正解が存在する場合に限って使える、最も直接的な指標である。
6.3 開発効率とレビュー負荷の指標
これらは品質を表すものではない。しかし、AI駆動開発でボトルネックがレビューへ移った以上、品質保証の仕組みが持続可能かどうかを見るために必要な指標である。
- 信頼できる状態に至るまでの時間:機能追加や修正の依頼から、その成果物について品質の証拠が揃うまでの時間。「コードができるまでの時間」との差分が、検証にかかっている時間を表す。短いから品質が高いという意味ではなく、品質を示す活動が開発の流れを止めていないかを見るための指標である。
- 作業単位あたりの人間の確認時間:一つの作業単位を通すために、人間が確認に費やす時間。この値が下がらなければ、AIによる生成の速さは全体の速さにならない。同時に、第5章の移行が進んでいるかどうかを測る目安にもなる。
最後に、目標値の置き方について付け加えておきたい。既存システムをAIで再現するような検証では、6.1節の単体テストのカバレッジとは別に、再現率の到達目標をあらかじめ明示して臨むのが現実的である。100%を目指すと、得られる価値に見合わない工数がかかるからである。
ただし、これは目標に届かなかった部分を軽視するという意味ではない。埋まらなかった差分こそが最も重要な情報であり、それを設計書やプロセスへ戻していくことが目的である。再現できなかった部分は、失敗としてではなく「適用限界の発見」として報告すればよい。何ができなかったかを正直に示せることも、品質の証拠の一部である。
7. まだ答えの出ていない問い
私たちは実案件の中でこの仕組みを運用しながら改善している。その中で、業界としてまだ答えの出ていない問いがある。現時点で答えが出ていないものを挙げておく。
- 独立したAIは、本当に独立していると言えるか。 同じ系統のモデルや似たプロンプトを使えば、同じ誤解を共有するおそれがある。モデルを分けるだけでなく、正解情報、検査の方式、権限、実行環境のそれぞれで独立性を確保する必要がある。
- 移行条件をどう定量化するか。 第5章で示した各段階の移行条件は、方向性の提案にとどまる。「一定期間」「許容範囲」を具体的にどう置くかは、組織や領域ごとに検証が必要である。
- リスク分類はどこまで自動化できるか。 影響範囲の分析はAIに任せられても、リスク許容度そのものは組織が決めなければならない。
- 仕様を中心に置く開発は、品質を上げるのか、文書を増やすだけなのか。 AIに仕様を書かせると、論点を補完しすぎて要求が膨らむ現象を、私たちは実際に見ている。仕様を起点に開発を進めるためのツールが登場している(※11)一方で、生成される文書が冗長でレビューの負担が大きい、小さな修正には過剰である、といった批判もある(※12)。
- 品質基準や問いのセットを、どこに置き、どう版管理するか。 基準は継続的に改善されるが、その管理の方法は確立していない。
- プロセスを再設計した効果を、どう実証するか。 既存の研究の多くは「AIあり/なし」の比較である(※13)(※14)。本当に知りたいのは、「AIを使いながら従来のプロセスを維持する場合」と「AIを前提にプロセス自体を組み替えた場合」の差である。この比較は、まだ十分に行われていない。
8. 結び
AIの導入によって変わるのは、品質管理の目的ではなく手段である。要求の正しさ、重大リスクの抑制、独立した検証、追跡可能性。これらの価値はまったく色褪せていない。
変わるのは、それを実現する方法である。
- 工程の区切りごとの確認から、作業単位ごとの確認へ。
- 一律の審査から、リスクに応じた審査へ。
- 生成と検証が同じ主体の中にある状態から、分離された状態へ。
- 「レビューを実施した」という活動から、「正しいと示せる」証拠へ。
そして、この移行は一足飛びには進まない。まず全量確認から始めて観点を資産化し、生成と検証を分け、リスク分類と証拠の仕組みを整え、移行条件を満たしたところで一段ずつ確認の形を変えていく。その間も、確認の網羅性を効率より優先し続ける。
最終的に目指すのは、人間の確認をなくすことではない。
人間の注意力を、本当に人間にしか下せない判断へ集中させること。
それが、AI駆動開発時代の品質管理の核心だと私たちは考えている。
株式会社deeptierの取り組みについて
deeptierは、AI駆動開発を実案件に適用しながら、本稿で述べた品質保証の仕組みを開発しています。現行の品質管理規定をAI駆動開発に合わせて見直す支援、品質ゲートの設計と構築、発注者へ説明できる品質報告の形式づくり、本稿の移行ステップ(Step 1〜2)の伴走支援を行っています。事例の詳細は個別にご説明しますので、【お問い合わせフォーム】からご連絡ください。
本稿は2026年10月時点の筆者の知見とdeeptierの開発するナレッジマネジメントシステムを活用し、主にAIが作成した文章に加筆・修正して作成しています。
実践にもとづく見解であり、特定の顧客・案件の内容を示すものではありません。記載したツールやサービスの仕様、調査結果は、各出典の公開時点の情報です。
参考文献
※1 NASA, NASA Software Engineering and Assurance Handbook (NASA-HDBK-2203) — https://swehb.nasa.gov/
※2 GitLab, "GitLab Research Reveals Organizations Are Generating AI Code Faster Than They Can Control It" (2026-06-23) — https://about.gitlab.com/press/releases/2026-06-23-gitlab-research-reveals-organizations-are-generating-ai-code-faster-than-they-can-control-it/
※3 y0us91「AIが実装し、AIがテストし、AIが『問題ありません』と言う時代の品質保証」Qiita (2026-08-11) — https://qiita.com/y0us91/items/2feffd2cc6c672717973
※4 METR, "Many SWE-bench-Passing PRs Would Not Be Merged into Main" (2026-03-10) — https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
※5 DORA, "Capabilities: Working in small batches" — https://dora.dev/capabilities/working-in-small-batches/
※6 OpenAI, "Harness engineering: leveraging Codex in an agent-first world" (2026-02-11) — https://openai.com/index/harness-engineering/
※7 N. Alshahwan, M. Harman, et al. (Meta), "Assured LLM-Based Software Engineering" (2024) — https://arxiv.org/abs/2402.04380
※8 SQiP ソフトウェア品質保証プロフェッショナルの会 チーム5「AI活用時代における品質保証の進化 ― AI活用開発プロセスにおけるQAの再設計 ―」(2026) — https://www.juse.or.jp/sqip/community/bucyo/17/files/shiryou_seika3.pdf
※9 StrongDM, "Software Factories And The Agentic Moment" — https://factory.strongdm.ai/
※10 Google Testing Blog, "Code Coverage Best Practices" (2020) — https://testing.googleblog.com/2020/08/code-coverage-best-practices.html
※11 GitHub, Spec Kit — https://github.github.com/spec-kit/
※12 Birgitta Böckeler, "Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl" (2025-10-15) — https://martinfowler.com/articles/exploring-gen-ai/sdd-3-tools.html
※13 METR, "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity" (2025-07-10) — https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
※14 GitHub, "Does GitHub Copilot improve code quality? Here's what the data says" — https://github.blog/news-insights/research/does-github-copilot-improve-code-quality-heres-what-the-data-says/
【本記事の執筆者】
武内 開作
株式会社deeptier ファウンダー
2006年、IBM Business Consulting Services KKに新卒入社、戦略コンサルティング部門に所属。その後、OmnicomグループのグローバルPR会社のFleishman Hillard Japanを経て、戦略コンサルティング&投資会社である株式会社グルーツを創業。2014年、サイバーセキュリティ会社スプラウトを創業、2016年10月退任。
2021年にグルーツの事業再編に伴い、株式会社deeptierを創業。ファウンダーとして政策シミュレーション領域へのAI活用や、大手企業との共同プロジェクト等をリードしている。